Tech Stack
Description
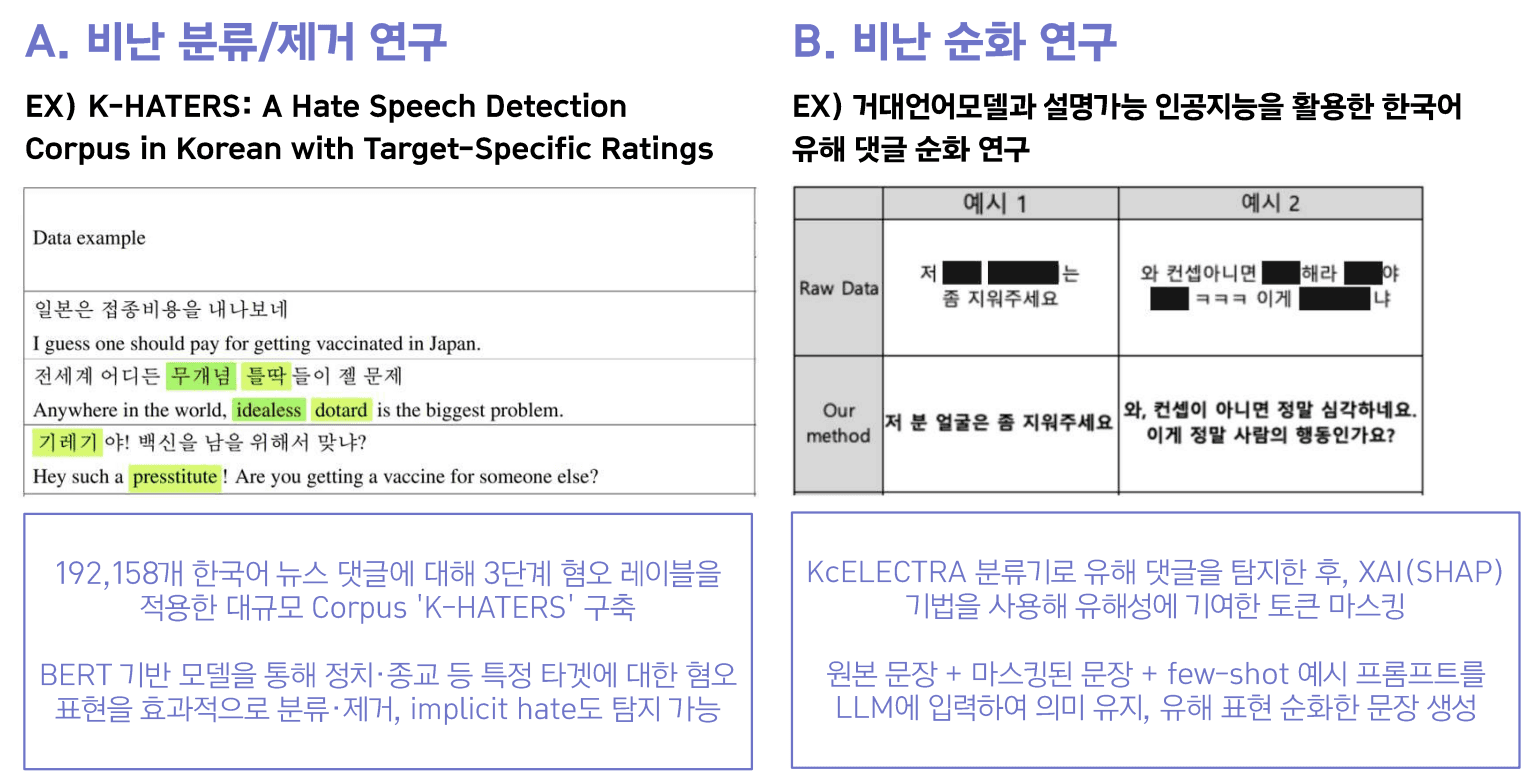
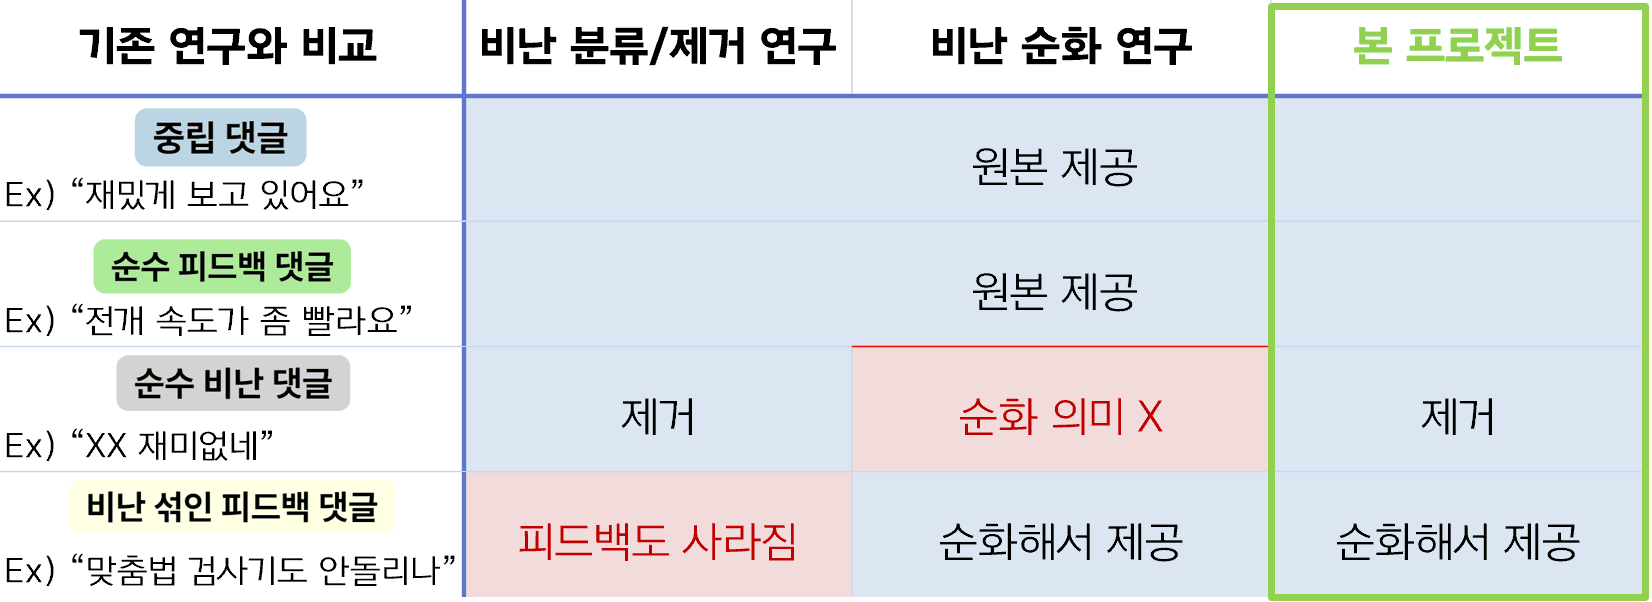
기존 악성 댓글 연구는 비난을 제거하거나 순화하는 데 집중하여, 창작자에게 필요한 피드백까지 함께 사라지는 문제가 있었습니다.
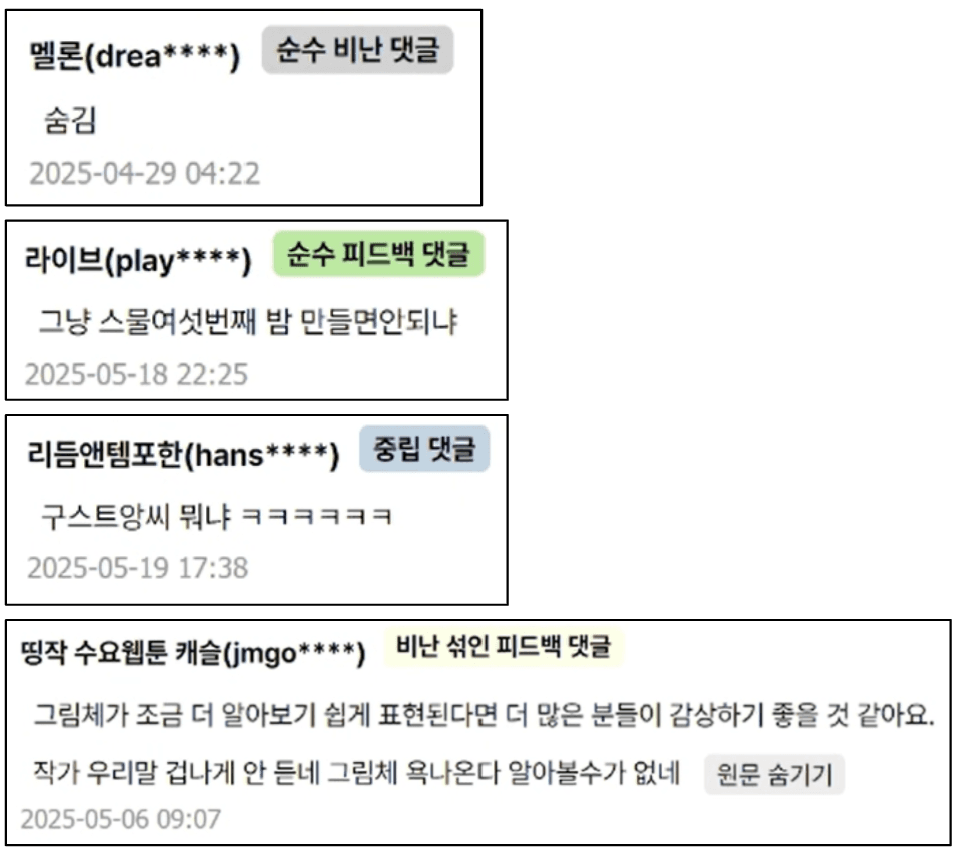
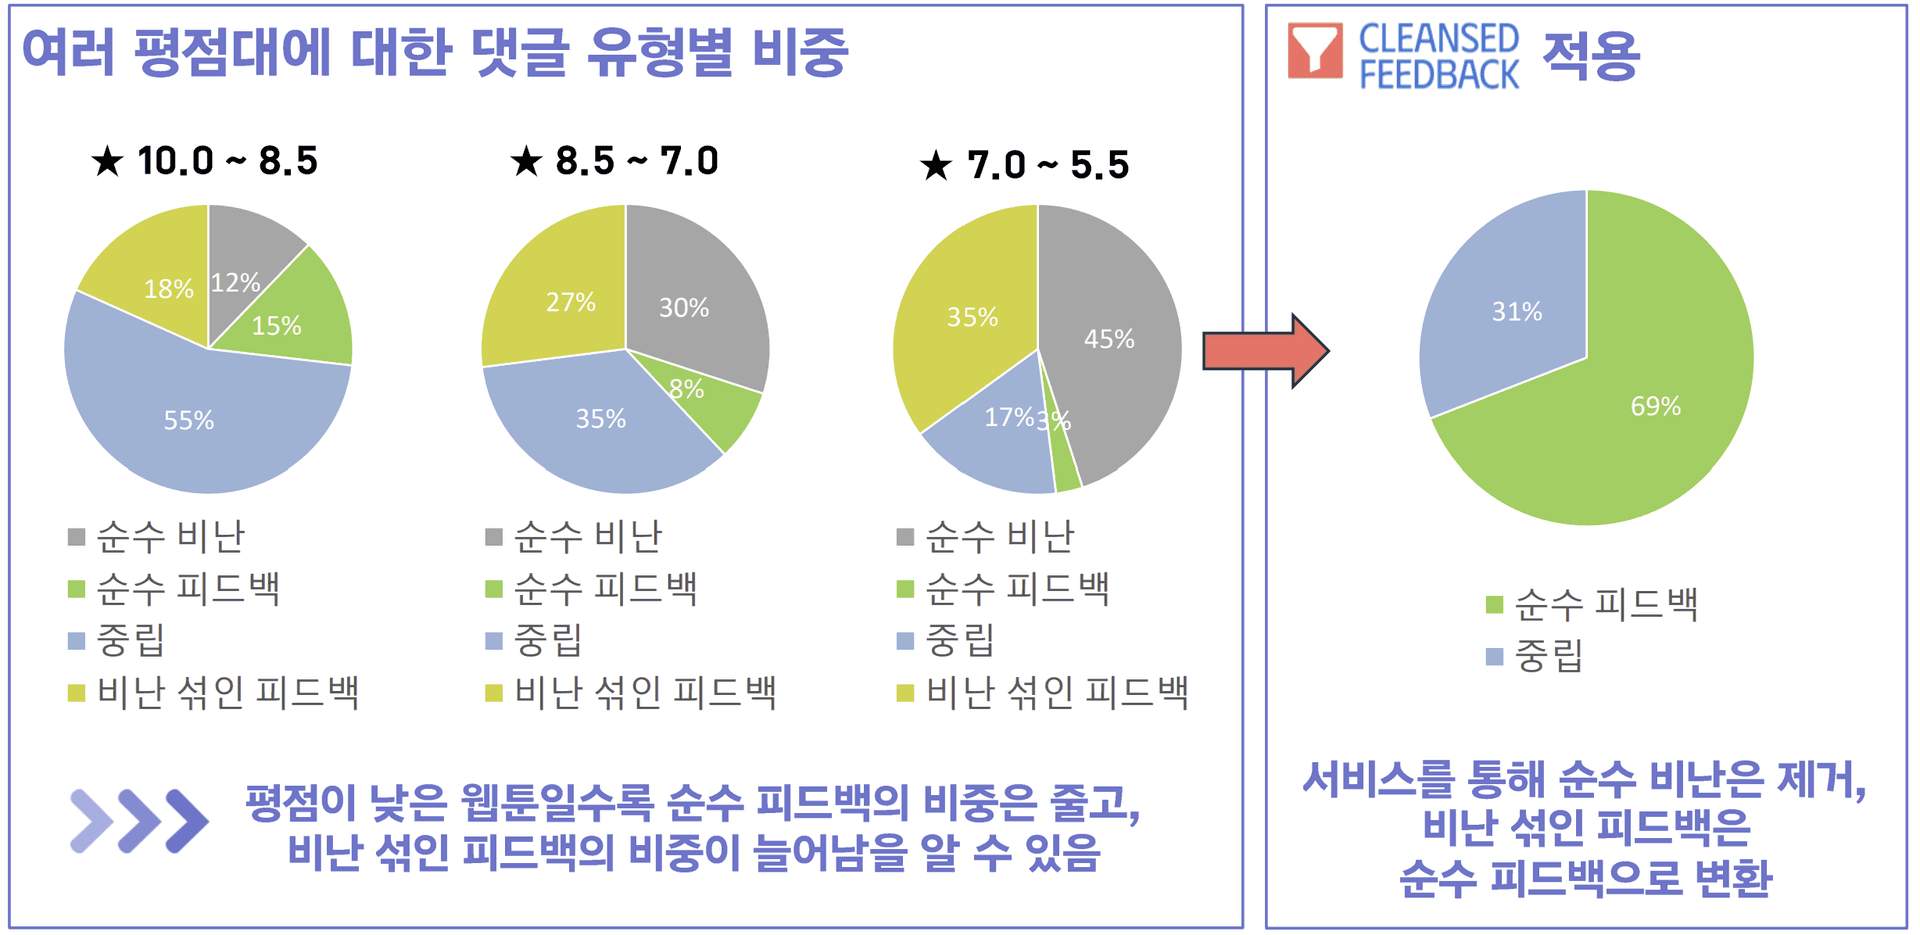
CleansedFeedback는 댓글을 '중립 / 순수 피드백 / 순수 비난 / 비난 섞인 피드백'의 네 가지 유형으로 분류한 뒤, 비난만 존재하는 댓글은 제거하고 피드백이 포함된 댓글은 GPT를 이용해 비난 표현만 순화하여 제공합니다.
Chrome Extension과 Flask 서버를 이용하여 실제 네이버 웹툰 댓글 페이지에서 동작하는 서비스 형태로 구현했습니다.
- Chrome Extension 기반 실시간 댓글 정제 서비스 구현
- KcELECTRA 기반 비난 분류 모델 활용
- GPT-4o를 활용한 자동 데이터 라벨링
- KcELECTRA Fine-tuning을 통한 피드백 분류 모델 개발
- LLM 기반 댓글 순화(Prompt Engineering)
- 실제 웹툰 서비스 환경에서 동작하는 End-to-End 파이프라인 구축
Page Info
Problem Definition
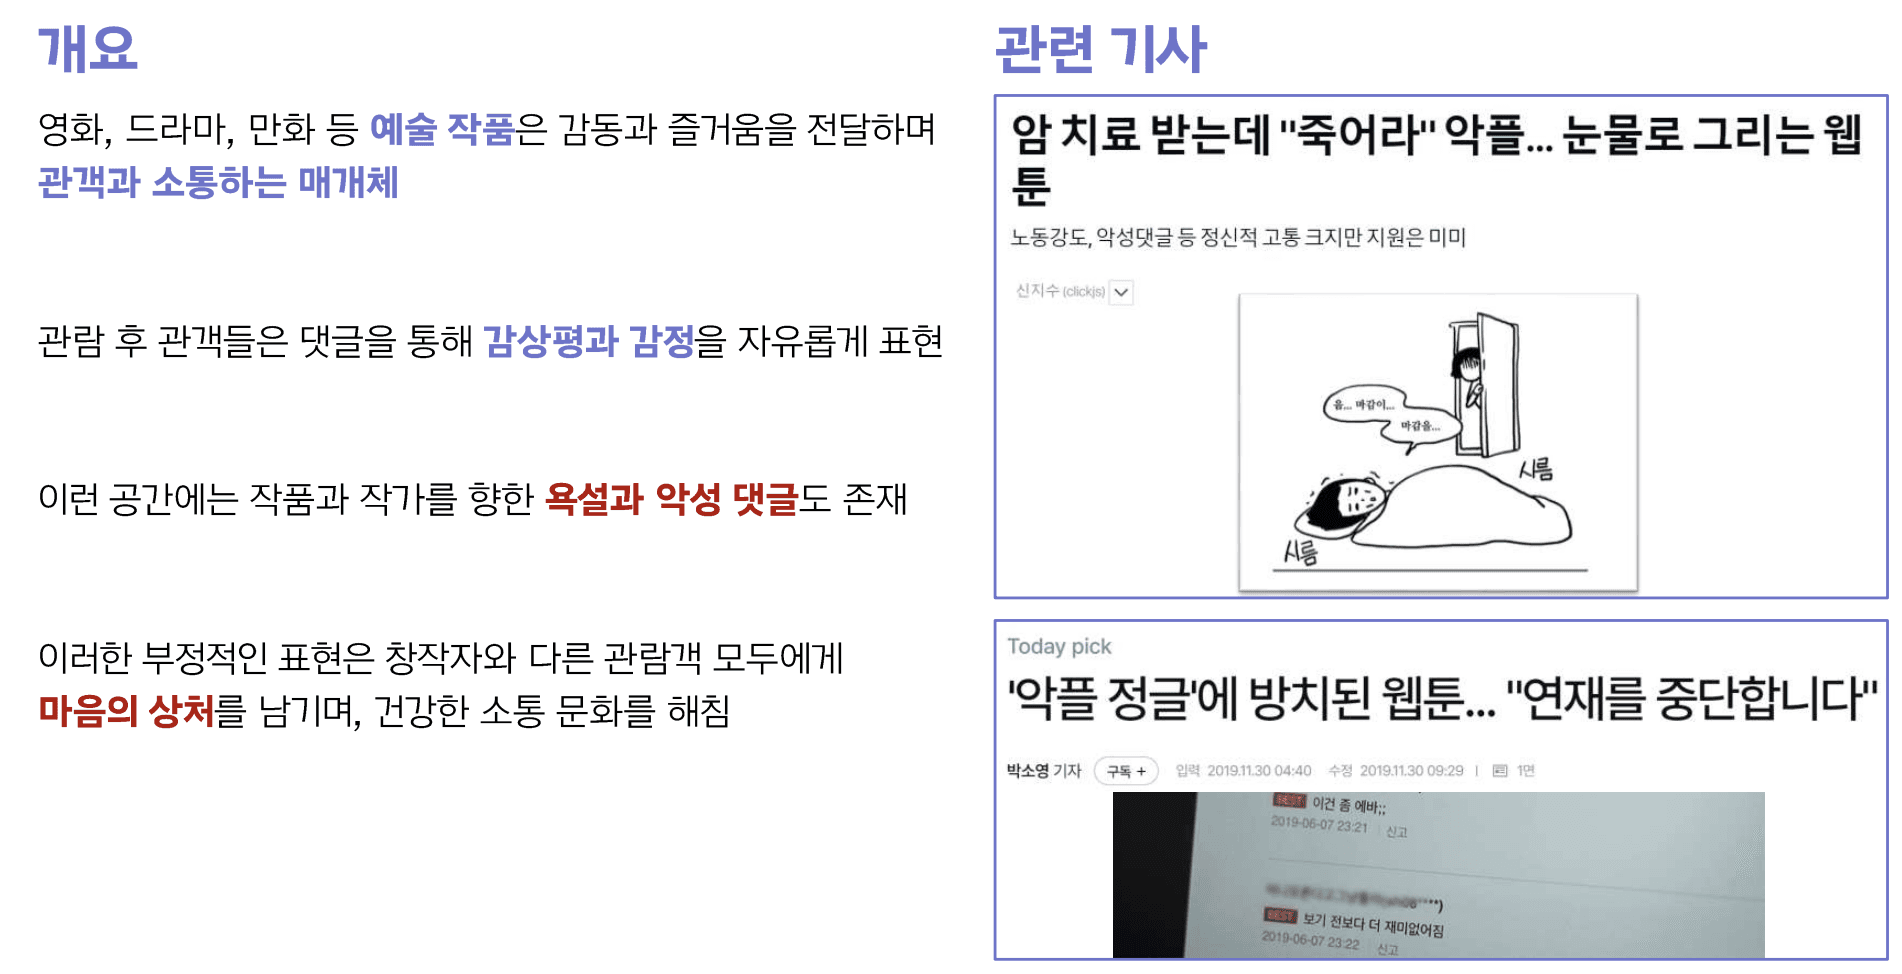
기존 악성 댓글 제거 방식은 건설적인 피드백까지 함께 삭제하여 창작자가 필요한 의견을 놓칠 수 있습니다. 본 프로젝트는 '비난'과 '피드백'을 구분하여 가치 있는 의견만 남기는 것을 목표로 했습니다.
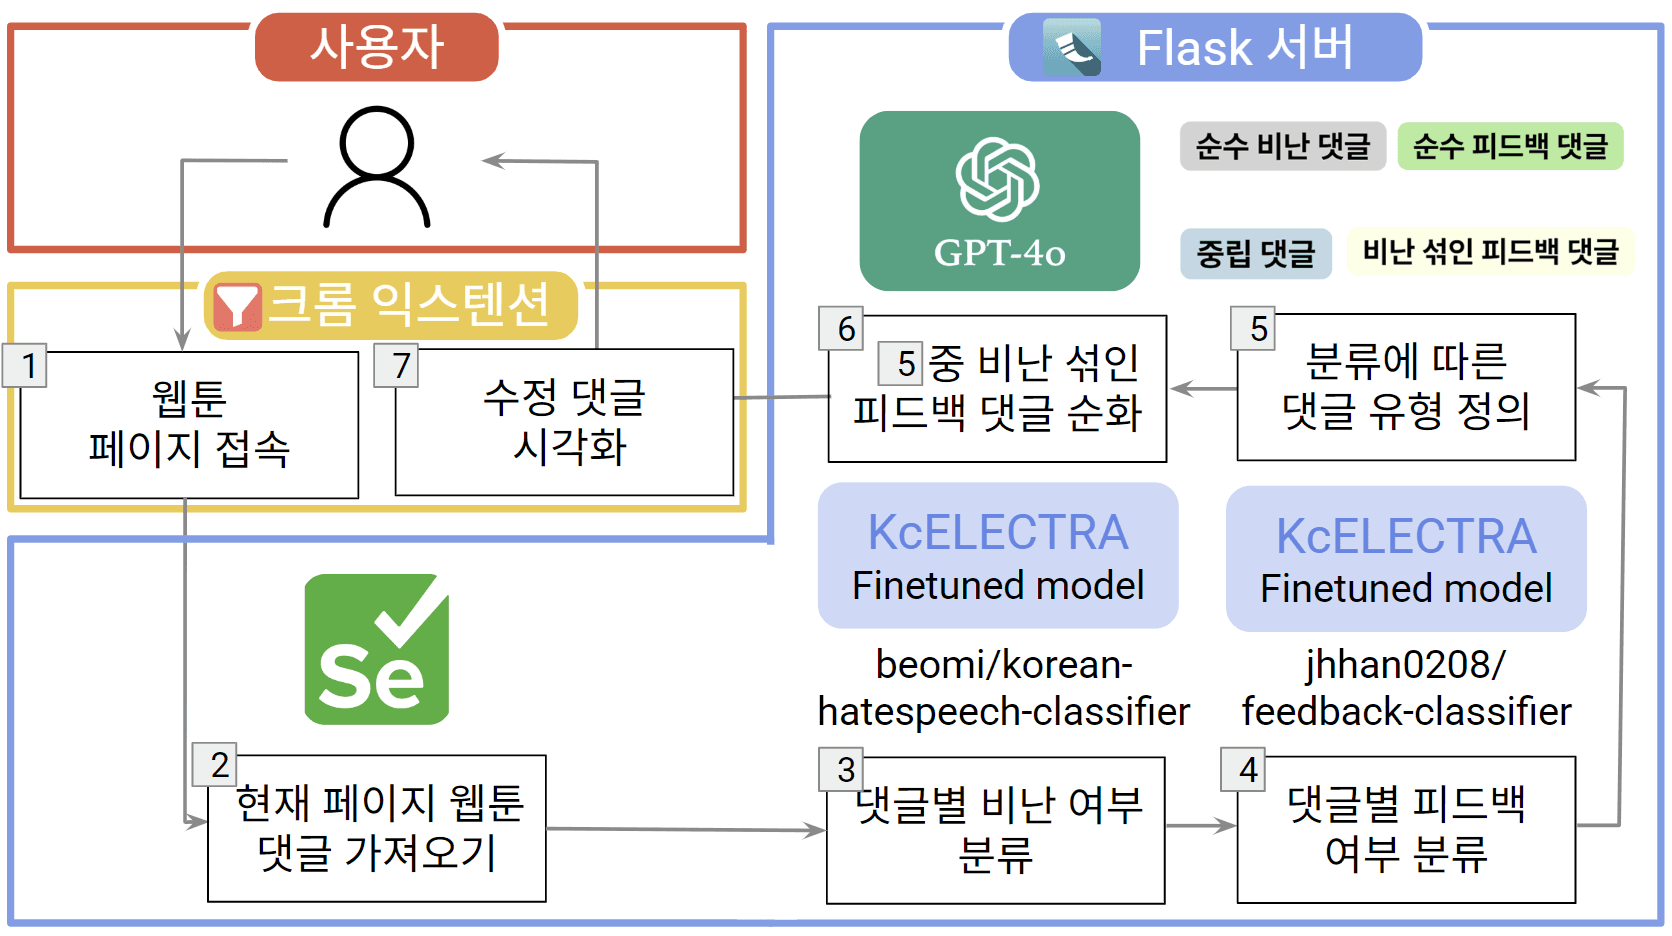
System Pipeline
Chrome Extension이 현재 웹툰 댓글을 수집하면 Flask 서버에서 비난 여부와 피드백 여부를 각각 분류하고, GPT-4o를 이용해 비난 섞인 피드백 댓글만 순화하여 다시 웹페이지에 표시합니다.
Dataset Construction
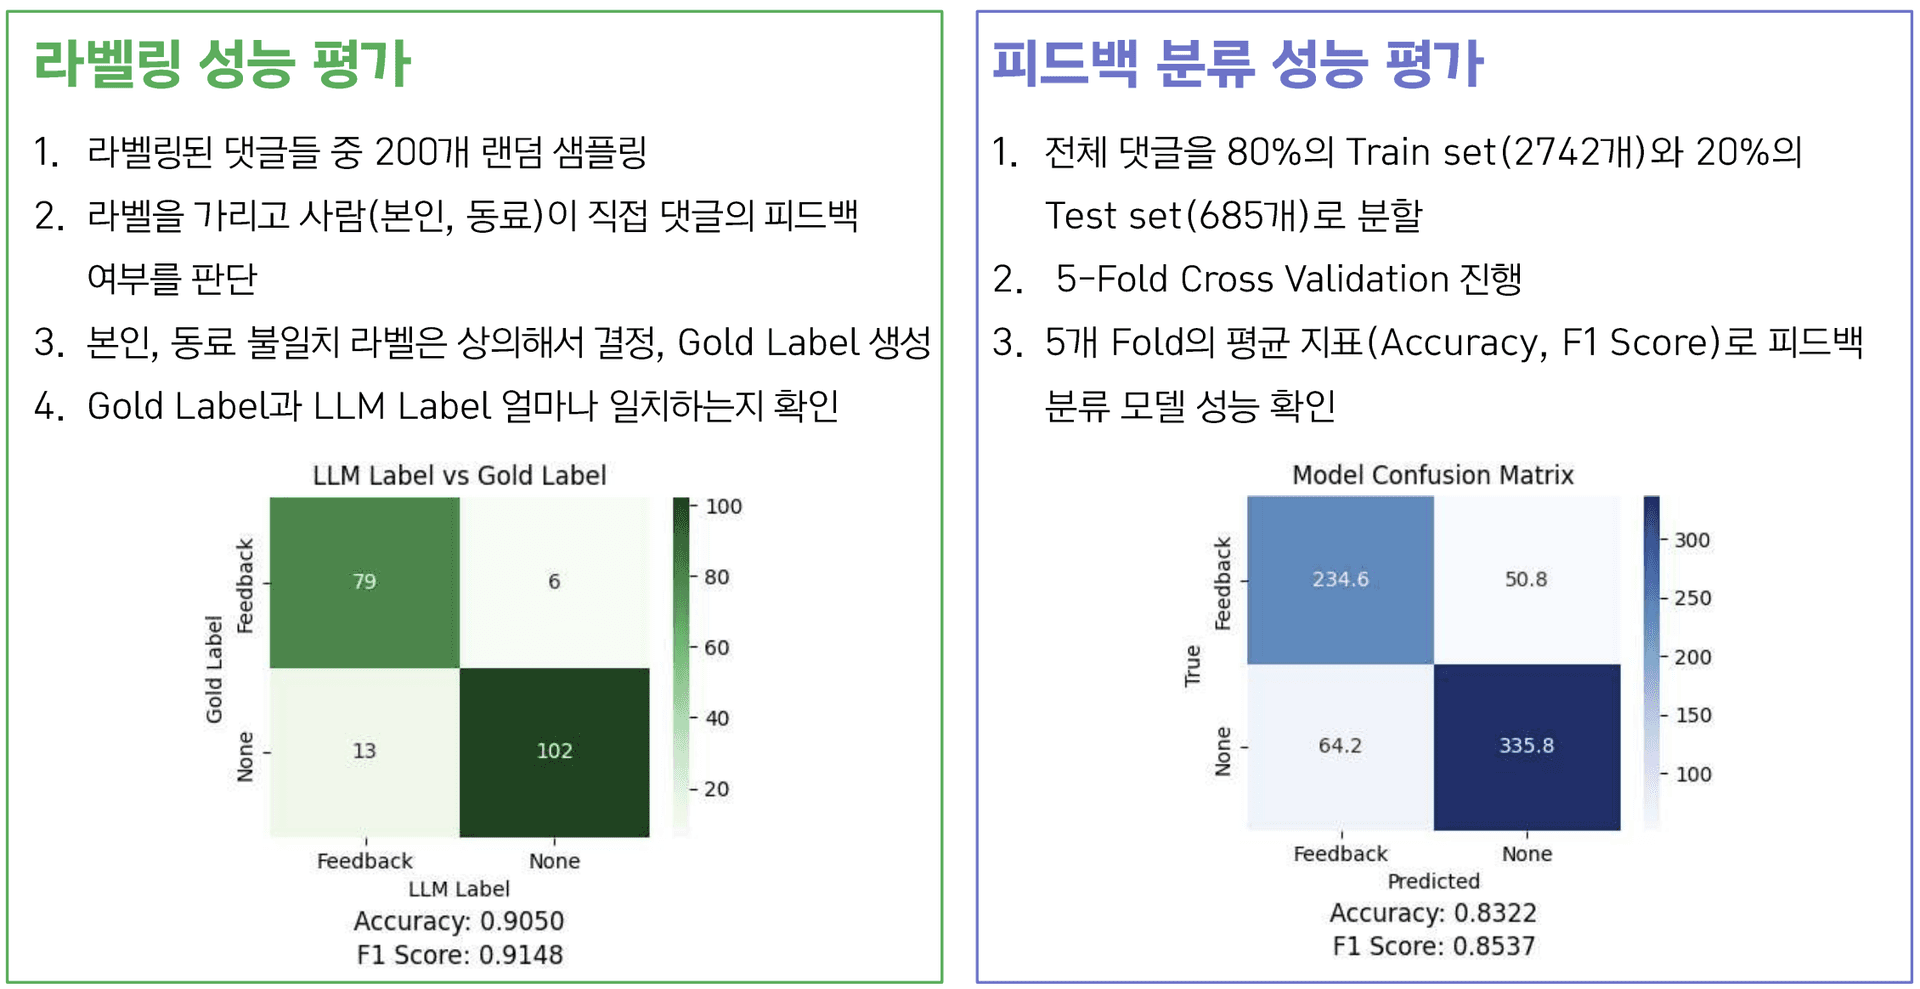
공개된 피드백 데이터셋이 존재하지 않아 다양한 평점의 네이버 웹툰 댓글을 직접 수집했습니다. GPT-4o를 활용해 1차 자동 라벨링을 수행하고, 무작위 샘플에 대해 사람 검증(Gold Label)을 진행하여 데이터셋의 신뢰성을 확보했습니다.
Model Training
피드백 데이터 불균형 문제를 해결하기 위해 Down Sampling을 적용했으며, KcELECTRA를 Fine-tuning하여 피드백 분류 모델을 구축했습니다. 이후 Hugging Face에 모델을 배포하여 서비스에서 활용했습니다.
Evaluation
GPT 라벨링은 Accuracy 약 0.90, F1 약 0.91을 기록했고, Fine-tuned KcELECTRA 모델은 5-Fold Cross Validation 기준 Accuracy 약 0.83, F1 Score 약 0.85를 달성했습니다.
Result
순수 비난 댓글은 제거되고, 비난 섞인 피드백은 순화된 피드백으로 변경되어 사용자에게 제공됩니다. 이를 통해 창작자는 감정적인 공격 없이 개선에 도움이 되는 의견만 확인할 수 있습니다.