
Tech Stack
Description
한국의 저출산 문제에 대응하기 위한 정부 정책이 경제적 지원에 집중되어 있다는 점에서 출발하여, 출산율과 관련된 사회·경제적 요인을 데이터로 분석한 개인 프로젝트입니다.
국가별 출산율과 GDP뿐 아니라 비만율, 성비, 문해율, 의료 수준, 부양비, 여성 경제활동 참가율을 결합하여 총 130개 국가의 분석 데이터를 구성했습니다.
분석은 세 가지 가설을 중심으로 진행했습니다. 먼저 여러 회귀 모델을 통해 출산율과 관련성이 높은 요인을 탐색하고, 다음으로 K-means를 이용해 한국과 사회적 조건이 유사한 국가를 찾았습니다. 마지막으로 GDP 수준에 따른 출산율 차이가 통계적으로 나타나는지 독립표본 t-test로 검토했습니다.
- 서로 다른 출처에서 수집한 8개 국가별 데이터셋 통합
- 국가명 불일치, 자료형 변환, 결측치와 이상치 처리
- 상관계수와 VIF를 활용한 독립변수 간 다중공선성 점검
- PCA·회귀·앙상블·군집화·가설검정을 결합한 단계별 분석
- 분석 결과를 바탕으로 경제적 지원 이외의 저출산 정책 방향 제안
Data Collection & Preprocessing
출산율에 영향을 줄 가능성이 있는 요인을 폭넓게 비교하기 위해 출산율, GDP, 비만율, 성비, 문해율, 의료 수준, 부양비, 여성 경제활동 참가율 데이터를 수집했습니다.
각 데이터셋은 포함된 국가와 국가명 표기 방식이 달랐기 때문에 공통 국가명을 기준으로 병합하고, 분석에 사용할 수 있도록 수치형 데이터로 변환했습니다.
- Listly를 이용해 국가별 지표가 포함된 웹 데이터를 수집하고 Excel 파일로 저장
- 통화 기호·천 단위 구분자·백분율 기호를 제거하고 데이터를 수치형으로 변환
- 각기 다른 출처의 데이터셋을 국가명을 기준으로 병합
- South Korea·Korea 등 서로 다르게 표기된 국가명을 공통 명칭으로 정규화
- 결측치가 있는 국가를 제외하고 130개 국가와 8개 속성으로 최종 데이터셋 구성
- 한국의 낮은 출산율은 데이터 오류가 아닌 분석 가치가 있는 이상치로 판단해 유지
Hypothesis 1
출산율과 관련된 사회적 요인은 무엇인가?
경제적 요인을 제외한 사회적 지표들이 출산율과 어떤 관계를 보이는지 확인하고, 여러 회귀 모델의 예측 성능과 선형 모델의 계수를 비교하여 주요 변수를 탐색했습니다.
Multicollinearity & PCA
독립변수 간 상관관계와 VIF를 확인한 결과 문해율과 의료 수준의 상관계수가 약 0.79로 상대적으로 높게 나타났습니다.
두 변수를 그대로 사용하는 대신 PCA를 적용하여 하나의 변수인 literacy_healthcare로 축소했습니다. 첫 번째 주성분은 기존 두 변수 분산의 약 89%를 설명했습니다.
- StandardScaler를 이용한 독립변수 표준화
- 상관계수 히트맵과 VIF를 활용한 다중공선성 점검
- 문해율과 의료 수준을 하나의 주성분으로 결합
- PCA 적용 전후의 독립변수 간 상관관계 비교
Regression Model Comparison
Linear Regression부터 부스팅 기반 모델까지 총 7개 회귀 모델을 동일한 학습·테스트 데이터에 적용하고 MAE, MSE, RMSE와 R²를 비교했습니다.
- LinearRegression·Ridge·Lasso를 활용한 선형 모델 비교
- VotingRegressor·BaggingRegressor를 이용한 앙상블 모델 평가
- AdaBoostRegressor·GradientBoostingRegressor를 이용한 부스팅 모델 평가
- Linear·Ridge·Lasso 회귀계수의 절댓값 평균을 이용해 변수 영향력 비교
- 노트북의 단일 데이터 분할 실험에서 AdaBoost와 Gradient Boosting이 0.9 이상의 R² 기록
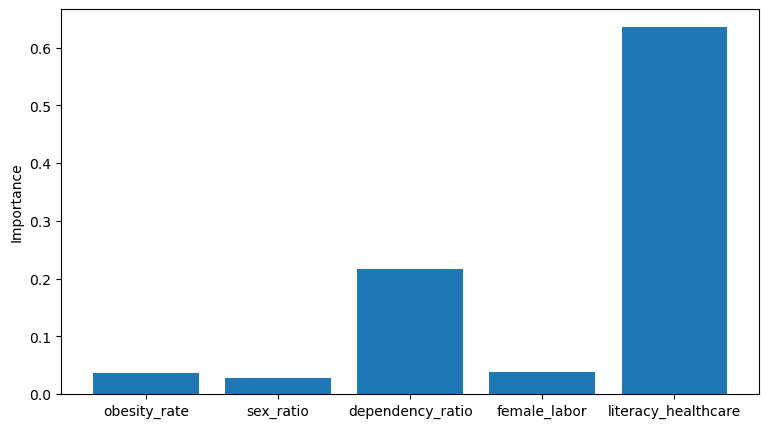
분석 결과 출산율과 관련성이 크게 나타난 변수는 문해율·의료 수준을 결합한 literacy_healthcare와 부양비였습니다.
특히 부양비와 출산율 사이에서 관찰된 관계를 바탕으로, 경제활동인구가 일과 육아를 병행할 때 발생하는 부담을 완화하는 정책이 필요하다는 방향을 제안했습니다.
Hypothesis 2
한국과 유사한 상황에 놓인 국가는 어디인가?
첫 번째 분석에서 출산율과 관련성이 높게 나타난 의료 수준과 부양비를 기준으로 국가를 군집화하고, 한국과 유사한 지표를 가진 국가를 탐색했습니다.
- 클러스터 수를 2개부터 5개까지 변경하며 Silhouette Score 비교
- Silhouette Score가 가장 높게 나타난 3개 군집을 최종 K값으로 선택
- 의료 수준과 부양비를 기준으로 K-means 군집화 수행
- Pairwise Distance를 이용해 한국과 가까운 국가 탐색
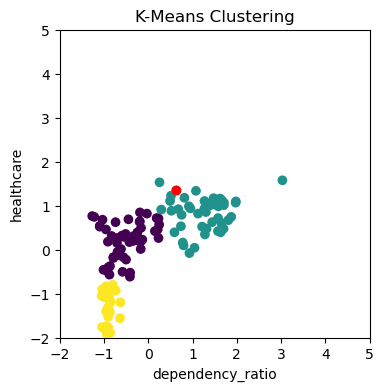
한국은 의료 수준과 부양비가 상대적으로 높은 군집에 포함되었습니다. 거리 계산 결과 한국과 유사하게 나타난 국가로 이스라엘, 아이슬란드, 룩셈부르크와 아일랜드를 확인했습니다.
이를 통해 단순히 출산율이 높은 국가를 참고하는 대신, 한국과 사회적 조건이 유사한 국가의 육아 지원 및 노동 정책을 비교하는 접근을 제안했습니다.
Hypothesis 3
경제력이 높은 국가일수록 출산율도 높은가?
경제적 지원 중심의 저출산 정책을 검토하기 위해 국가를 1인당 GDP 순으로 나누고, GDP가 높은 집단과 낮은 집단 사이의 출산율 차이를 독립표본 t-test로 분석했습니다.
- 159개 국가를 1인당 GDP 순으로 정렬
- GDP 상위 80개국과 하위 79개국을 서로 독립적인 표본으로 구성
- 양측검정과 두 방향의 단측검정을 각각 수행
- 표본 내에서 GDP가 높은 국가의 출산율이 더 높다는 근거를 확인하지 못함
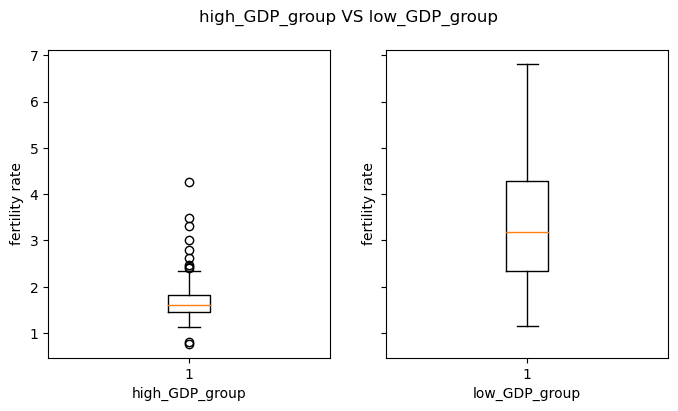
분석에서는 GDP가 높은 국가 집단의 출산율이 오히려 낮게 나타나는 경향을 확인했습니다.
이 결과를 바탕으로 경제적 지원을 축소해야 한다고 해석하기보다, 현금성 지원과 함께 육아휴직의 실질적 활용, 보육시설 접근성, 일과 육아의 병행 가능성을 개선하는 정책이 필요하다고 제안했습니다.
Conclusion
국가별 데이터를 활용한 분석을 통해 저출산 문제가 단일 경제 지표만으로 설명되기 어렵다는 점을 확인했습니다.
회귀 분석에서는 문해율·의료 수준·부양비가 출산율과 관련된 주요 요인으로 나타났고, 군집 분석을 통해 한국과 유사한 사회적 조건을 가진 국가를 탐색했습니다. 통계 검정에서는 높은 GDP가 높은 출산율로 직접 연결되지 않는 경향을 확인했습니다.
이를 바탕으로 저출산 정책은 금전적 지원에만 집중하기보다 경제활동인구가 육아를 병행할 수 있도록 노동·보육 환경을 함께 개선하는 방향으로 확장할 필요가 있다는 결론을 도출했습니다.
Limitations & Improvements
본 프로젝트는 국가 단위의 횡단면 데이터를 활용한 탐색적 분석으로, 변수 사이의 인과관계를 직접 입증하지는 않습니다.
- 서로 다른 출처와 조사 시점의 데이터를 결합해 지표 간 기준 연도가 일치하지 않을 가능성
- 단일 Train·Test Split의 R²만으로 모델의 일반화 성능을 판단하기 어려우므로 교차검증 필요
- 모델별 하이퍼파라미터 탐색과 반복 실험을 통한 성능 안정성 검증 필요
- GDP 상·하위 집단의 등분산 여부를 먼저 검정하고 결과에 따라 Welch t-test를 적용할 필요
- 국가별 문화·주거·보육 정책처럼 데이터에 포함되지 않은 교란 요인을 추가할 필요
- 시계열 또는 패널 데이터를 활용해 정책 시행 전후의 변화와 인과관계를 분석할 필요
Repository
저장소에는 전체 분석 과정이 기록된 Jupyter Notebook과 국가별 원본 Excel 데이터, 데이터 출처를 설명하는 참고 이미지가 포함되어 있습니다.